Подготовка к защите / self-check
Вопросы для защиты
Не заучивайте формулировки. Разберитесь, как устроен ваш эксперимент, и попробуйте объяснить каждое понятие своими словами. Ответы помогут проверить себя. Здесь 23 вопроса: про машинное обучение, цифровой мир и IoT.
Содержание страницы
Видео от Google 2018: создание беспилотного управления машиной
Видео: беспилотное управление автомобилем
Что такое IoT и микроконтроллер?
IoT (интернет вещей) — это сеть физических устройств (датчиков, контроллеров, приборов), которые собирают данные и могут автоматически обмениваться ими по сети.
Микроконтроллер — это небольшой компьютер внутри устройства, который управляет его работой: считывает данные с датчиков, обрабатывает их и управляет исполнительными механизмами.
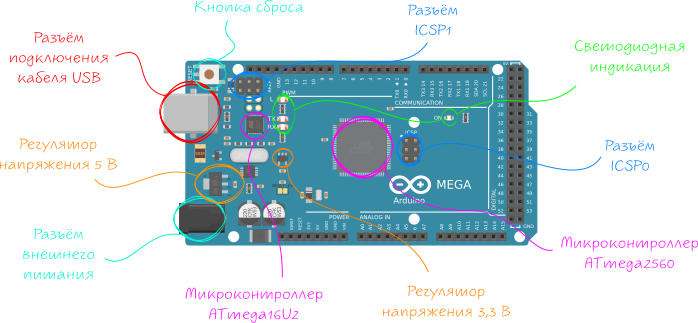
Arduino Mega — отладочная/разработческая плата, построенная на микроконтроллере ATmega2560.
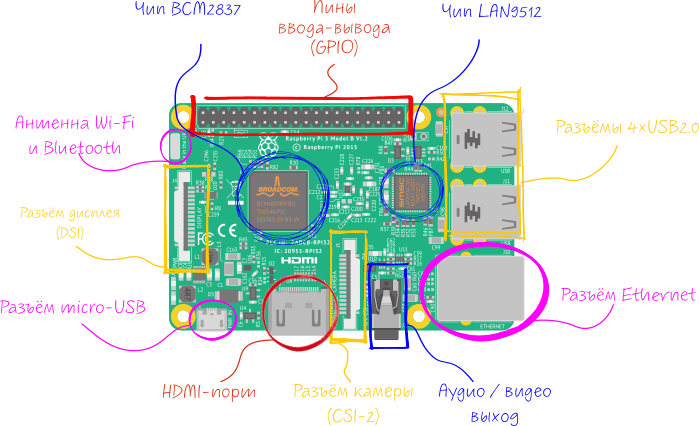
Raspberry Pi — семейство одноплатных компьютеров. Например, Raspberry Pi 4 построен на SoC Broadcom BCM2711.
Например, датчик в теплице измеряет температуру, микроконтроллер сравнивает её с заданным порогом и включает вентилятор. Измерение, решение и действие — разные части одной системы. Интернет нужен, чтобы передавать показания или управлять устройством удалённо; местная автоматика может работать и без него.
Микроконтроллер обычно выполняет небольшую программу и напрямую общается с электроникой. Одноплатный компьютер чаще запускает полноценную операционную систему и более тяжёлые приложения (например, веб-сервер или обработку изображения с камеры). Выбор зависит от задачи, питания и требуемых вычислений.
Как устройства общаются между собой?
Устройства могут передавать данные по Wi-Fi, Bluetooth или проводным соединениям (USB, Serial, UART, I2C, SPI, Ethernet и т. д.), используя протоколы обмена данными для связи между собой и сервером.
Важно различать способ подключения и правила общения. Провод или радиоканал помогают передать сигнал, а протокол определяет, как участники понимают сообщения (какие поля в пакете, когда отвечать и что считать ошибкой). Наличие Wi-Fi само по себе ещё не означает, что устройство подключено к интернету.
Например, микроконтроллер получает измерение датчика по I²C, а затем отправляет его серверу через Wi-Fi с помощью HTTP или MQTT. На каждом участке используются свои правила, хотя пользователь видит одно показание температуры в приложении.
Что такое интернет?
Интернет — это глобальная распределённая сеть, объединяющая компьютеры и серверы по всему миру для передачи данных по стандартным протоколам.
Физически интернет в большинстве случаев — это проводная инфраструктура: оптоволоконные и медные кабели, проложенные между городами, странами и даже континентами (включая подводные кабели через океаны).
Wi-Fi и мобильная связь часто обеспечивают доступ от устройства до роутера или базовой станции. Дальше трафик обычно идёт по проводной инфраструктуре, но существуют и радиорелейные, и спутниковые участки связи.
Интернет и Всемирная паутина — разные понятия. Интернет соединяет сети, а Web — одна из работающих поверх него служб: сайты, ссылки и HTTP. Электронная почта, видеосвязь и обмен сообщениями тоже используют интернет, но не сводятся к открытию веб-страниц.
Когда вы открываете сайт, данные проходят через несколько сетей. Маршрут может измениться при сбое. Поэтому у интернета нет единственного «главного компьютера», выключение которого останавливает всё сразу.
Что такое ИИ, МЛ, и нейросеть?
ИИ — это общее направление, цель которого — создать системы,
способные выполнять задачи, требующие «интеллекта»
(например, распознавание, планирование, принятие решений).
МЛ — это один из подходов внутри ИИ, где система не
программируется жёстко, а обучается на данных, выявляя
закономерности. Нейросеть — это уже конкретный инструмент в
МЛ: модель, вдохновлённая работой мозга, состоящая из слоёв
«нейронов», которая хорошо подходит для сложных задач вроде
обработки изображений, текста и звука.
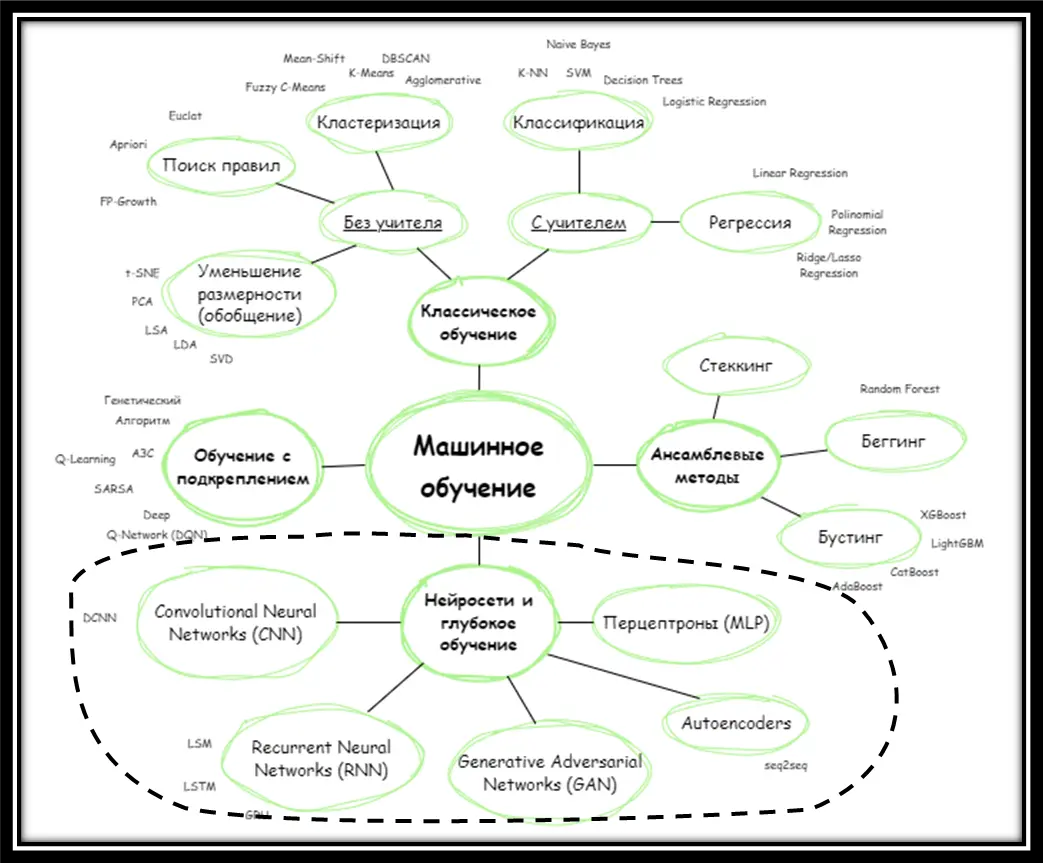
Эти понятия вложены друг в друга: не всякий ИИ использует машинное обучение, и не всякое машинное обучение использует нейросети. Например, модель дерева решений учится на примерах, но нейросетью не является.
При обучении модель подбирает внутренние параметры, а при использовании применяет уже найденные параметры к новому примеру. Во время распознавания одного снимка она обычно не переобучается заново (как ученик решает новую задачу, опираясь на прошлую подготовку).
Что такое трансфер-лернинг?
Трансфер-лернинг — это метод, при котором модель, предварительно обученная на большом датасете, используется как основа для решения новой задачи с дообучением под конкретные данные.
Для распознавания своих объектов не обязательно начинать с модели, которая ещё ничего не умеет. Предобученная модель уже выделяет полезные признаки изображения, а дообучение помогает приспособить их к вашим классам. Это часто уменьшает требования к объёму новых данных и времени обучения.
Но похожесть задач важна: опыт на одних данных не гарантирует качества на других. Результат всё равно проверяют на отдельной выборке, а не только на тех изображениях, которые модель видела при дообучении.
Что такое аугментация?
Аугментация — это метод искусственного расширения обучающего набора данных путём модификации исходных примеров (повороты, масштабирование, изменение яркости и т.д.) для повышения обобщающей способности модели.
Смысл аугментации — показать модели допустимые варианты одного объекта: он может оказаться чуть темнее, ближе или повёрнутее. При изменении изображения нужно правильно изменить и разметку, например координаты рамок.
Преобразование не должно менять смысл класса. Перевёрнутая цифра 6 может стать похожей на 9, а сильное обрезание может полностью убрать объект. Обычно аугментируют обучающую часть; проверочные данные должны оставаться независимыми и отражать реальные условия.
Что такое галлюцинации?
Галлюцинации — генерация моделью недостоверных или
отсутствующих в данных фактов при недостаточной информации
или выходе за область обучения.
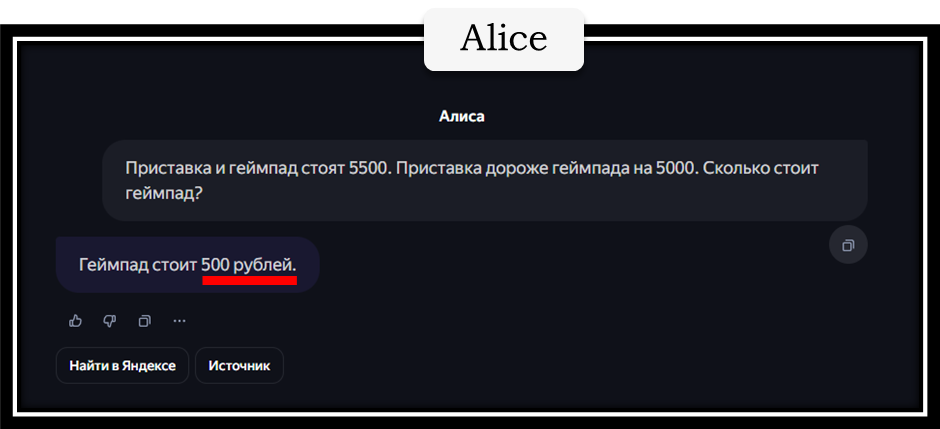
Например, модель может сослаться на несуществующую статью или придумать параметр функции. Уверенный тон ответа не является доказательством его правильности: правдоподобный текст и проверенный факт — разные вещи.
Ответ проверяют по первоисточнику, вычислению или работающему эксперименту. В коде помогают документация и запуск примера. Если источника нет или вопрос неоднозначен, лучше явно указать неопределённость, чем выдавать предположение за установленный факт.
Что такое датасет и эпоха?
Датасет — это набор структурированных данных (например, изображений с метками), используемый для обучения и тестирования модели. Датасет включает входные данные и соответствующие им ответы (метки).
Эпоха — это один полный проход по обучающему датасету во время обучения модели.
Датасет — не просто папка с любыми файлами: для обучения важны представительность, качество и корректные метки. Сто одинаковых фотографий одного предмета дают меньше полезного разнообразия, чем снимки при разном освещении и с разных ракурсов.
Одна эпоха означает проход по всей обучающей выборке. Она обычно состоит из нескольких шагов по небольшим порциям данных — батчам. Больше эпох не всегда лучше: модель может начать запоминать особенности обучения вместо полезных общих закономерностей.
Что такое детекция, классификация и сегментация?
Детекция — задача нахождения и локализации объектов на изображении с указанием их координат. (выделяем объекты в прямоугольники и классифицирует их)
Классификация — задача присвоения объекту на изображении одного из заранее определённых классов. (распознает что на картинке)
Сегментация — задача разделения изображения на области,
относящиеся к разным объектам, для точного определения их
формы и расположения. (выделяем объекты по контуру и
классифицируем их)
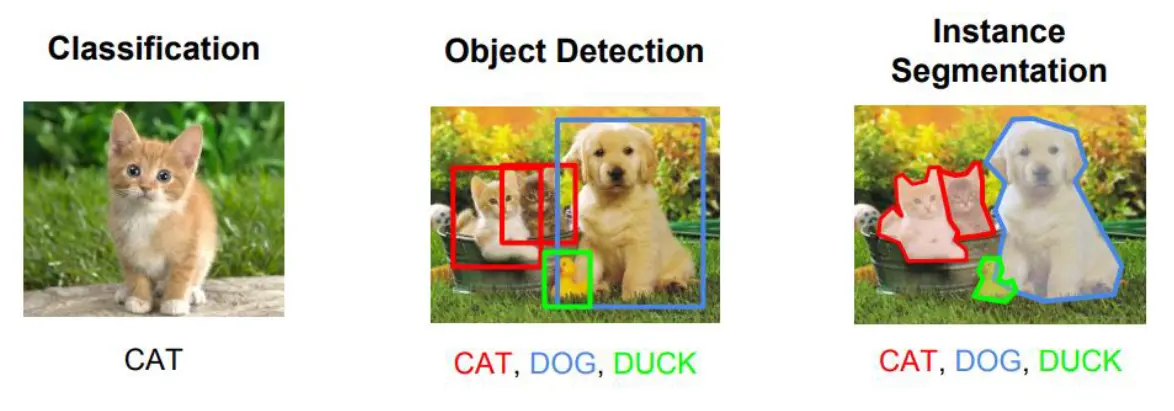
Классификация отвечает «что на изображении?», детекция добавляет «где именно?», а сегментация выделяет область объекта по пикселям. На снимке дороги классификация может сообщить «есть машины», детекция нарисует рамки вокруг машин, а сегментация отделит их силуэты от фона.
Нужная разметка и метрики зависят от выбранной задачи. Нельзя оценивать точность расположения рамок только тем, правильно ли модель угадала название класса. Сначала формулируют, какой результат нужен приложению.
Какие входные параметры бывают у нейросетей?
Основные: числовые (например, пиксели изображения), текстовые (например, слова или предложения), категориальные (например, метки) и временные ряды (например, данные по времени). Могут быть и болле сложные типы данных.
Под входными данными понимают то, что модель получает для обработки: пиксели, текстовые токены, звук или значения признаков. Например, таблица может содержать температуру и влажность, а изображение — массив значений цветовых каналов.
Отдельно существуют гиперпараметры обучения: число эпох, размер батча и скорость обучения. Это настройки процесса, а не признаки конкретного примера. Их не стоит смешивать с весами модели, которые подбираются автоматически во время обучения.
Зачем делят датасет на обучающий, валидационный и тестовый выборки?
Чтобы обучать модель, проверять её качество во время обучения и оценивать на новых данных, не использованных в обучении.
На обучающей части меняются веса, на валидационной сравнивают варианты и выбирают настройки, а тестовую берегут для итоговой оценки. Если постоянно подбирать решения под тест, он фактически перестанет быть независимой проверкой.
Особенно опасны почти одинаковые снимки в разных частях: модель может узнать знакомый кадр, и оценка окажется слишком оптимистичной. Связанные данные разделяют с учётом источника: например, по видеозаписям, людям или времени съёмки.
Чем отличаются underfit, fit и overfit?
Недообучение (underfitting) — модель слишком простая или плохо обучена: плохо работает и на обучающих, и на тестовых данных. Не улавливает закономерности. Нормальное обучение (good fit) — баланс между обобщением и точностью: хорошо работает и на обучающих, и на тестовых данных. → Улавливает реальные зависимости. Переобучение (overfitting) — модель слишком подстроилась под обучающую выборку: отлично работает на обучающих данных, но плохо — на новых (тестовых). → Запоминает шум вместо закономерностей.
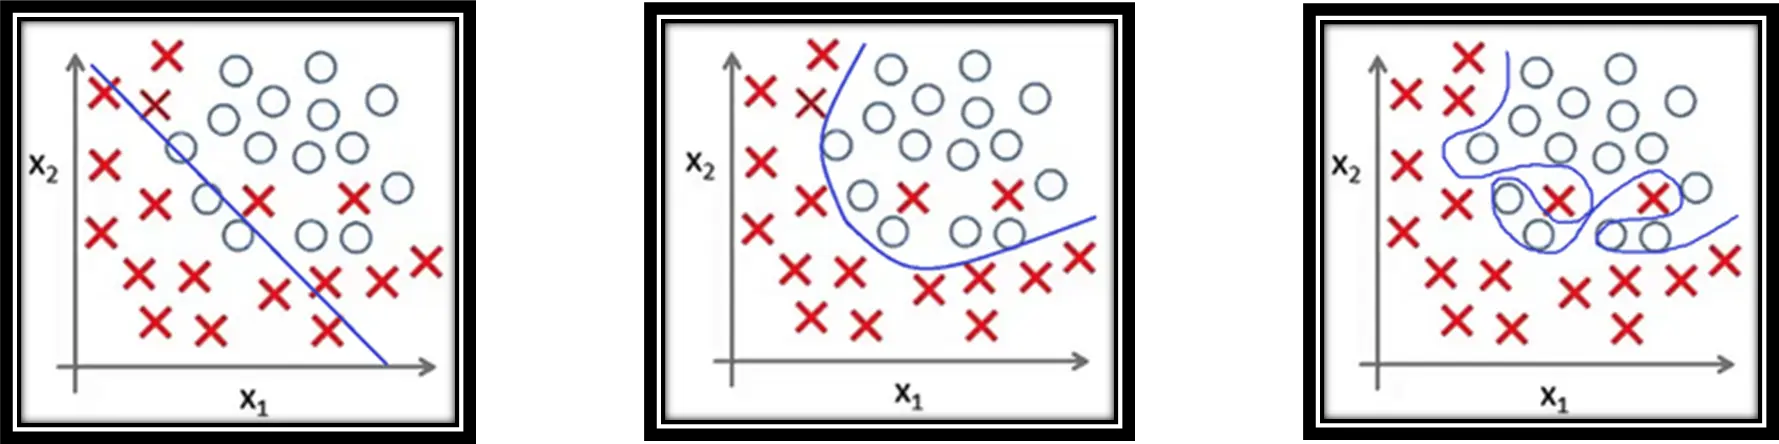
При недообучении модель плохо справляется даже с учебными примерами. При переобучении результат на обучении хороший, а на новых данных заметно хуже. Поэтому на один показатель качества без указания выборки смотреть недостаточно.
Сравнивают ошибки обучения и валидации, анализируют конкретные промахи. Иногда нужны более разнообразные данные или регуляризация, иногда — другая модель или больше обучения. Универсальной кнопки «исправить переобучение» нет: решение зависит от причины.
Почему своя LLM - дорого?
LLM (Large Language Model) — большая языковая модель, которая может предсказывать и генерировать текст на основе большого количества данных. (deepseek, chatgpt, Алиса и тд.)
Потенциально может потребоваться большой датасет, мощные вычислительные ресурсы и много времени для обучения модели, особенно если она сложная. Также может потребоваться эксперименты с архитектурой и гиперпараметрами, что увеличивает затраты.
График цен акция Intel и Nvidia
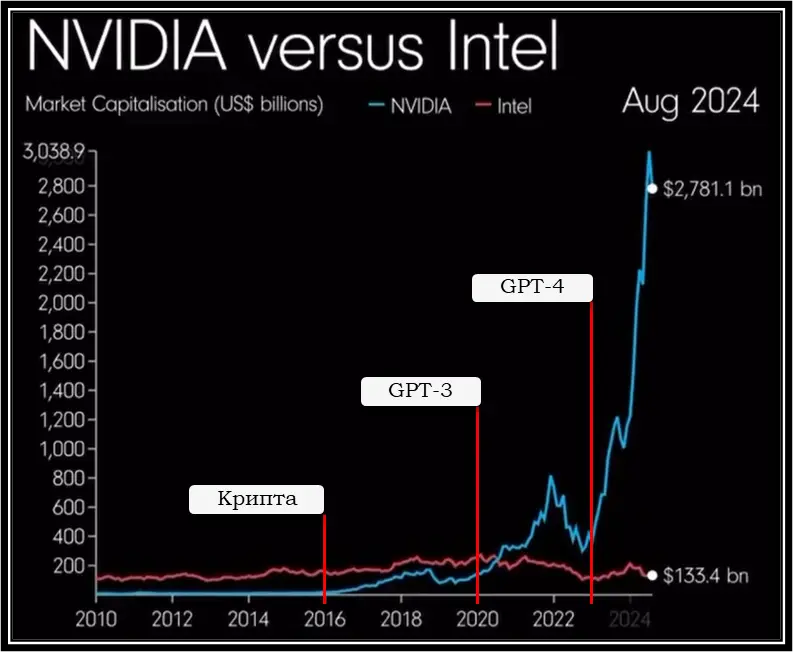
Нужно различать обучение большой модели с нуля, дообучение готовой модели и запуск уже обученной модели. Это задачи разного масштаба. Для своей прикладной функции часто достаточно существующей модели и небольшого приложения вокруг неё.
Даже готовую модель нужно где-то хранить и исполнять: веса и промежуточные вычисления занимают память, а обработка длинных запросов и большого числа пользователей требует ресурсов. К стоимости инфраструктуры добавляется подготовка данных, оценка качества и поддержка сервиса.
Что такое суммаризация и OCR в ML?
Задача суммаризации (автоматического реферирования) текста — это одна из задач NLP — обработки естественного языка, заключающаяся в создании краткой версии (пересказ) исходного документа (или набора документов) с сохранением его основного смысла и ключевой информации
OCR (Optical Character Recognition) — процесс распознавания текста на изображении с помощью компьютерного зрения. OCR - сокращение от оптического распознавания символов.
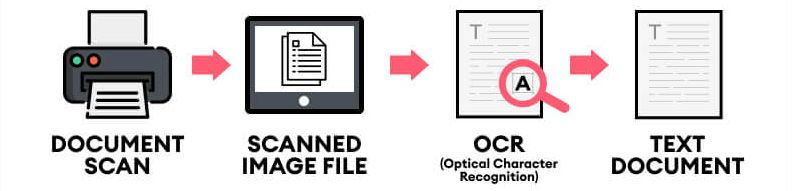
Суммаризация сокращает содержание, а OCR превращает изображение текста в текстовые символы. Если загрузить скан отчёта, сначала можно распознать надписи, а уже затем сделать краткий пересказ. Это две отдельные задачи в одной цепочке.
Обе стадии могут ошибаться: OCR путает похожие символы и таблицы, а пересказ может потерять оговорку или важное число. Для отчётов полезно сверять итог с исходным документом, особенно если от деталей зависит вывод.
Виды нейросетей
Линейная регрессия — простой базовый метод предсказания чисел, с которым можно сравнивать нейросети
Convolutional Neural Network (CNN) - сверточная нейросеть для изображений
Recurrent Neural Network (RNN) - рекуррентная нейросеть для временных характеристик (звук)
Transformer - многослойная нейросеть с вниманием для задач с текстом
Generative Adversarial Network (GAN) - нейросеть для генерации изображений
TabM - нейросеть для работы с табличными данными
Архитектуру выбирают под тип данных и задачу, а не по популярности названия. Сверточные сети полезны для локальных признаков изображений; рекуррентные сети учитывают порядок последовательности; внимание в трансформерах помогает связывать разные её части. Трансформеры применяются и к изображениям, и к звуку.
Начинать сравнение полезно с простого базового решения. Линейная регрессия сама по себе не является нейросетью: это модель для предсказания числового значения. Для классификации существуют другие модели, например логистическая регрессия. Более сложная архитектура должна оправдываться качеством на независимых данных.
Что такое бит, байт и двоичные данные?
Бит — это одно двоичное значение: 0 или 1. Байт обычно состоит из восьми бит и может представлять 256 разных комбинаций. Текст, фотография и музыка хранятся как последовательности данных; их смысл определяется форматом и программой, которая их читает.
Один символ текста не всегда занимает один байт. Например, в UTF-8 разные символы кодируются разным количеством байтов. Поэтому длина текста в символах и размер файла — разные величины. Сжатие уменьшает объём хранения, но способ восстановления зависит от выбранного формата.
Зачем нужны IP-адреса и DNS?
IP-адрес помогает доставлять пакеты нужному участнику сети, а DNS сопоставляет удобное доменное имя с адресами и другими записями. Когда вы вводите адрес сайта, браузеру обычно нужно сначала узнать, куда обращаться (похоже на поиск номера по имени в справочнике).
Один домен может соответствовать нескольким IP-адресам, а на одном сервере могут работать разные сайты. DNS-ответы кэшируются, поэтому изменение записи не обязано становиться видимым всем одновременно. При диагностике полезно отличать ошибку поиска имени от недоступности самого сервера.
Что происходит после ввода адреса сайта?
Браузер разбирает URL, определяет сервер и устанавливает соединение. Для HTTPS он также договаривается о защищённом обмене, затем отправляет HTTP-запрос. В ответ приходят статус, заголовки и содержимое; после HTML браузер может отдельно запросить стили, скрипты и изображения.
Статусы помогают понять результат: 200 означает успешный ответ, 404 — что запрошенный ресурс не найден, 503 — что сервис сейчас недоступен. Получить HTTP-ответ и получить нужную страницу — разные результаты. Сетевая ошибка может случиться ещё до того, как сервер вообще ответит.
Где находятся данные в облаке и зачем нужна резервная копия?
Облако — это вычисления и хранение на удалённых серверах, доступ к которым предоставляется через сеть. Данные всё равно находятся на физических носителях; просто инфраструктурой управляет поставщик сервиса. При работе приложения часть данных может храниться и на вашем устройстве.
Синхронизация и резервная копия решают разные задачи. Если удаление сразу синхронизируется на все устройства, оно может убрать все актуальные экземпляры файла. Резервная копия должна позволять восстановить нужное состояние; её полезно хранить отдельно и проверять восстановление на практике.
Как защищать аккаунты и распознавать фишинг?
Фишинг — это попытка выдать поддельную страницу или сообщение за доверенный сервис, чтобы получить пароль, код или другие данные. Проверяйте полный адрес сайта, не передавайте одноразовые коды собеседнику и осторожно относитесь к неожиданным просьбам срочно войти в аккаунт.
Для разных сервисов полезны разные длинные пароли и менеджер паролей. Дополнительный фактор входа усложняет захват аккаунта при утечке пароля. HTTPS защищает передачу данных до выбранного сайта, но сам по себе не доказывает, что сайт честный: поддельный ресурс тоже может использовать защищённое соединение.
Чем датчик отличается от исполнительного устройства в IoT?
Датчик измеряет состояние окружающего мира: температуру, освещённость, давление или положение. Исполнительное устройство меняет это состояние: реле включает насос, двигатель открывает заслонку, светодиод показывает сигнал. Контроллер связывает измерение с действием по программе.
Например, датчик сообщает, что почва сухая, а контроллер запускает полив через реле. В реальном устройстве нужны ограничения: максимальное время работы, защита от неверных показаний и подходящая электрическая схема. Измерение может быть шумным или устаревшим, поэтому одно странное число не всегда должно немедленно запускать механизм.
Как MQTT и брокер связывают IoT-устройства?
MQTT использует модель «публикация — подписка». Датчик публикует сообщение в тему, например greenhouse/temperature, а брокер передаёт его подписанным клиентам. Отправителю не нужно знать адрес каждого экрана или приложения, которым нужны эти показания.
Устройство управления может отдельно подписаться на тему команд. Нужно заранее договориться о формате данных, частоте сообщений и правах доступа. Сохранённое брокером последнее сообщение удобно для нового клиента, но его возраст всё равно важен: вчерашняя температура не является свежим измерением.
Что делать IoT-устройству, если пропал интернет?
Если действие критично для работы устройства, полезно выполнять базовую логику локально: поддерживать температуру, ограничивать время работы насоса и переходить в заранее определённое безопасное состояние. Это пример обработки на устройстве или рядом с ним — edge computing.
Показания можно временно сохранять с отметками времени и передавать после восстановления связи. При повторной отправке сервер должен уметь распознавать дубликаты. Облачная часть удобна для истории, аналитики и удалённого доступа, но её отсутствие не должно автоматически лишать устройство всей местной логики.
Три вопроса для самопроверки
Выберите три случайных вопроса из 23. Сначала ответьте своими словами, затем раскройте пояснения и сравните.