Вопросы по IoT и ML
Видео от Google 2018: создание беспилотного управления машиной
Что такое IoT и микроконтроллер?
IoT (интернет вещей) — это сеть физических устройств (датчиков, контроллеров, приборов), которые собирают данные и обмениваются ими через интернет без участия человека.
Микроконтроллер — это небольшой компьютер внутри устройства, который управляет его работой: считывает данные с датчиков, обрабатывает их и управляет исполнительными механизмами.
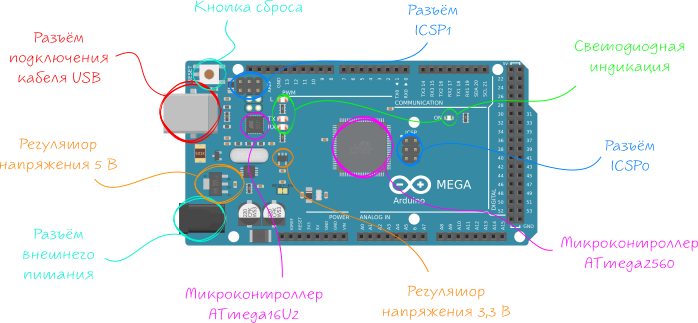
Arduino Mega - отладочная/разработческая плата, построенная на микроконтроллере ATmega2560.
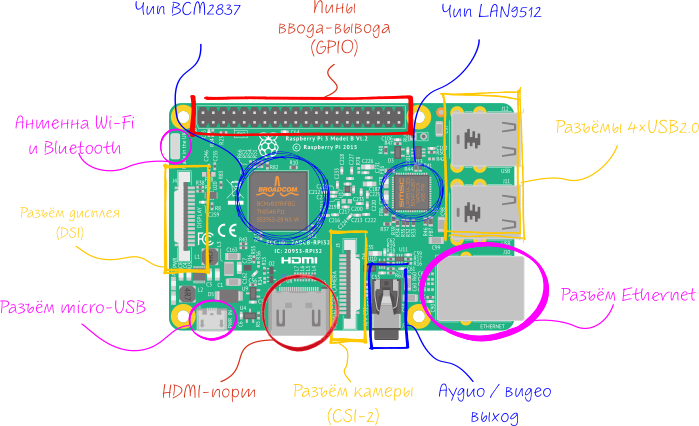
Raspberry - одноплатный компьютер (Single-Board Computer), построенный на базе SoC Broadcom BCM2711.
Как устройства общаются между собой?
Устройства могут передавать данные по Wi-Fi, Bluetooth или проводным соединениям (USB, Serial, UART, I2C, SPI, Ethernet, WGA и тд.), используя протоколы обмена данными для связи между собой и сервером.
Что такое интернет?
Интернет — это глобальная распределённая сеть, объединяющая компьютеры и серверы по всему миру для передачи данных по стандартным протоколам.
Физически интернет в большинстве случаев — это проводная инфраструктура: оптоволоконные и медные кабели, проложенные между городами, странами и даже континентами (включая подводные кабели через океаны).
Беспроводные технологии (Wi-Fi, мобильная связь) используются только на последнем участке — от устройства до ближайшей базовой станции или роутера, после чего данные всё равно передаются по проводам.
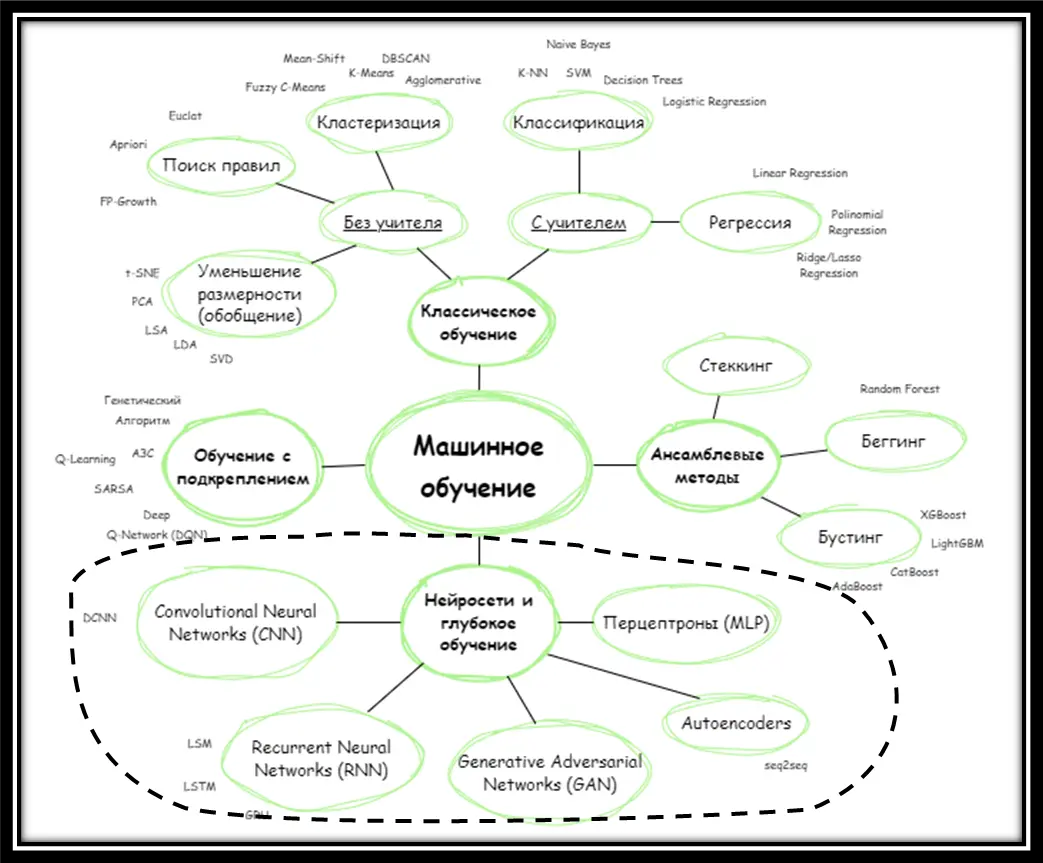
Что такое ИИ, МЛ, и нейросеть?
ИИ — это общее направление, цель которого — создать системы,
способные выполнять задачи, требующие «интеллекта»
(например, распознавание, планирование, принятие решений).
МЛ — это один из подходов внутри ИИ, где система не
программируется жёстко, а обучается на данных, выявляя
закономерности. Нейросеть — это уже конкретный инструмент в
МЛ: модель, вдохновлённая работой мозга, состоящая из слоёв
«нейронов», которая хорошо подходит для сложных задач вроде
обработки изображений, текста и звука.
Что такое трансфер-лернинг?
Трансфер-лернинг — это метод, при котором модель, предварительно обученная на большом датасете, используется как основа для решения новой задачи с дообучением под конкретные данные.
Что такое аугментация?
Аугментация — это метод искусственного расширения обучающего набора данных путём модификации исходных примеров (повороты, масштабирование, изменение яркости и т.д.) для повышения обобщающей способности модели.
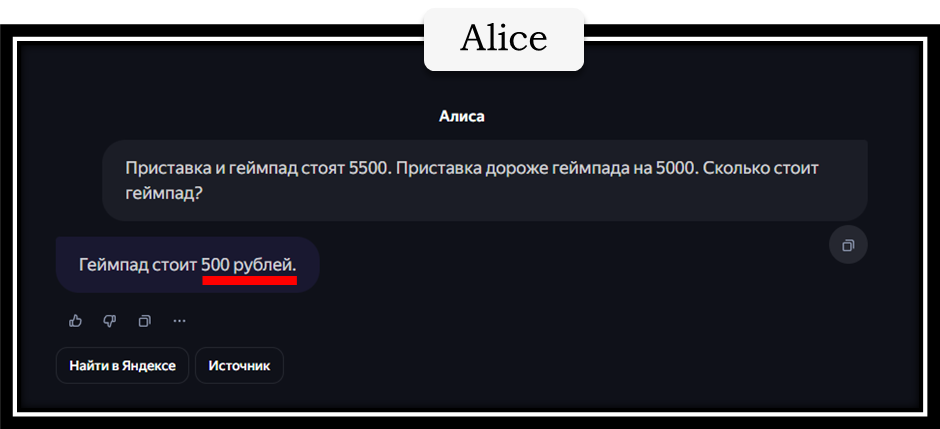
7. Что такое галлюцинации?
Галлюцинации — генерация моделью недостоверных или
отсутствующих в данных фактов при недостаточной информации
или выходе за область обучения.
Что такое датасет и эпоха?
Датасет — это набор структурированных данных (например, изображений с метками), используемый для обучения и тестирования модели. Датасет включает входные данные и соответствующие им ответы (метки).
Эпоха — это один полный проход по обучающему датасету во время обучения модели.
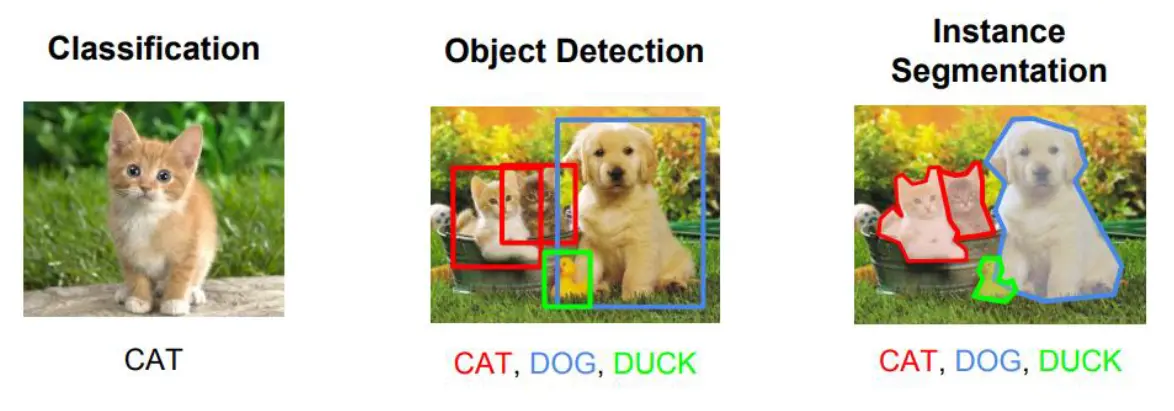
Что такое детекция, классификация и сегментация?
Детекция — задача нахождения и локализации объектов на изображении с указанием их координат. (выделяем объекты в прямоугольники и классифицирует их)
Классификация — задача присвоения объекту на изображении одного из заранее определённых классов. (распознает что на картинке)
Сегментация — задача разделения изображения на области,
относящиеся к разным объектам, для точного определения их
формы и расположения. (выделяем объекты по контуру и
классифицируем их)
Какие входные параметры бывают у нейросетей?
Основные: числовые (например, пиксели изображения), текстовые (например, слова или предложения), категориальные (например, метки) и временные ряды (например, данные по времени). Могут быть и болле сложные типы данных.
Зачем делят датасет на обучающий, валидационный и тестовый выборки?
Чтобы обучать модель, проверять её качество во время обучения и оценивать на новых данных, не использованных в обучении.
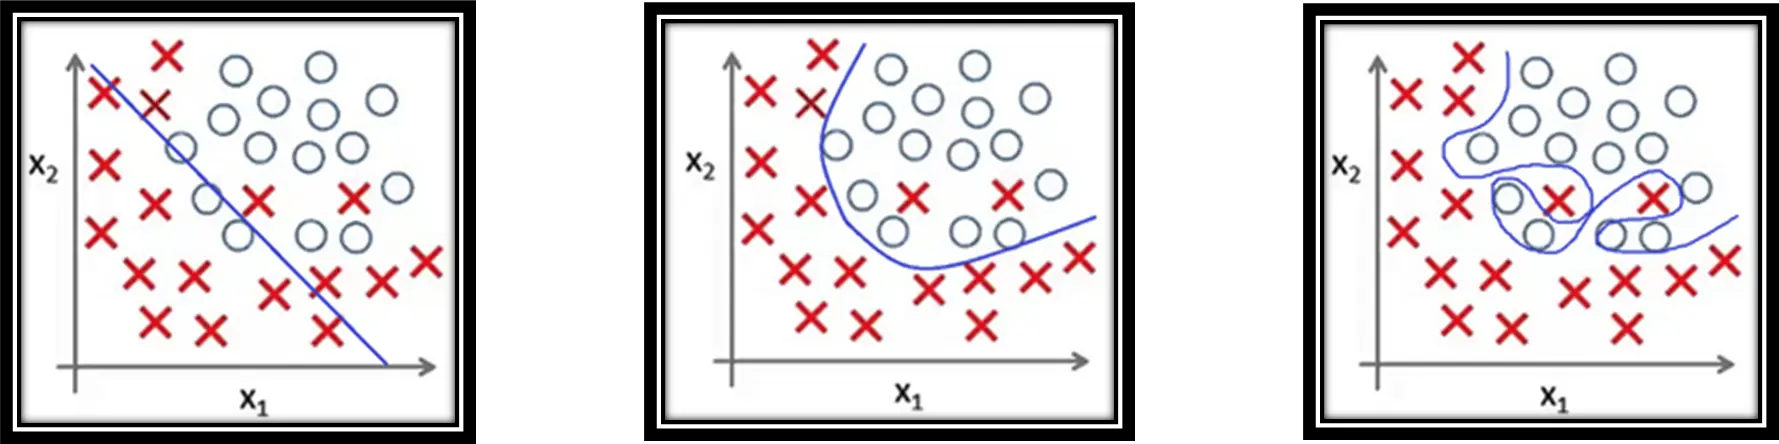
Чем отличаются underfit, fit и overfit?
Недообучение (underfitting) — модель слишком простая или плохо обучена: плохо работает и на обучающих, и на тестовых данных. Не улавливает закономерности. Нормальное обучение (good fit) — баланс между обобщением и точностью: хорошо работает и на обучающих, и на тестовых данных. → Улавливает реальные зависимости. Переобучение (overfitting) — модель слишком подстроилась под обучающую выборку: отлично работает на обучающих данных, но плохо — на новых (тестовых). → Запоминает шум вместо закономерностей.
Почему своя LLM - дорого?
LLM (Large Language Model) — большая языковая модель, которая может предсказывать и генерировать текст на основе большого количества данных. (deepseek, chatgpt, Алиса и тд.)
Потенциально может потребоваться большой датасет, мощные вычислительные ресурсы и много времени для обучения модели, особенно если она сложная. Также может потребоваться эксперименты с архитектурой и гиперпараметрами, что увеличивает затраты.
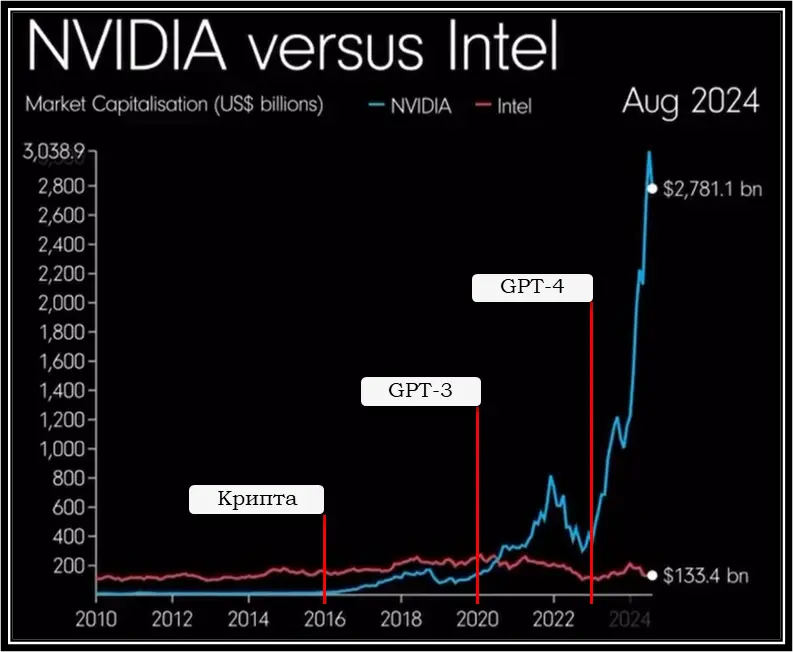
График цен акция Intel и Nvidia
Что такое суммаризация и OCR в ML?
Задача суммаризации (автоматического реферирования) текста — это одна из задач NLP - нейро-языкового программирования, заключающаяся в создании краткой версии (пересказ) исходного документа (или набора документов) с сохранением его основного смысла и ключевой информации
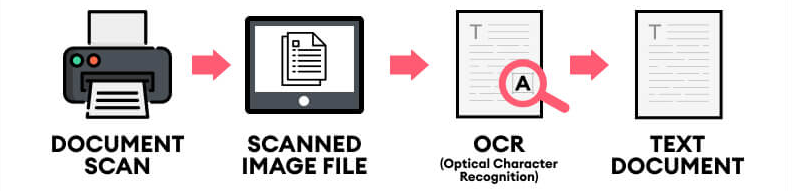
OCR (Optical Character Recognition) — процесс распознавания текста на изображении с помощью компьютерного зрения. OCR - сокращение от оптического распознавания символов.
Виды нейросетей
Linear Regression - линейная регрессия для предсказания чисел или класса
Convolutional Neural Network (CNN) - сверточная нейросеть для изображений
Recurrent Neural Network (RNN) - рекуррентная нейросеть для временных характеристик (звук)
Transformer - многослойная нейросеть с вниманием для задач с текстом
Generative Adversarial Network (GAN) - нейросеть для генерации изображений
TabM - нейросеть для работы с табличными данными